第04章 技术路线:四条路、一张选型图
本章导读
本章回答选型的第一个问题:同样一栋楼,为什么有人用脚本批量生成、有人从零重建、有人先扫描再拟合、有人指望 AI 一把出图,而这四种做法在工期、成本与返工风险上的差别并不落在同一处。它把四条路线逐条拆开——图纸规则化半自动、参数化 BIM 重建、点云 / 实景逆向(scan-to-BIM)、AI 端到端——给出各自的原理、适用条件、精度上限、人力结构与失败模式,再用图 2 的定位图与图 3 的场景适配矩阵把它们放进同一张坐标里比较。前置内容只有第01章的语义与可核查要求,以及第03章的外部约束,不依赖任何具体软件的操作细节。读完你会建立一个判断:路线之争大多是伪命题,真实项目里四条路线常同时出现在同一栋楼的不同部位,值得花力气的不是选出“最好的一条”,而是说清每条路的能力边界与代价。
学习目标
读完本章,你应当能够:
- 复述四条技术路线的原理,并说明规则化半自动为什么把一次性劳动变成可复用资产、又为什么会背上“工具债”;
- 对照表 14 的五个维度(适用条件、精度上限、人力结构、典型周期、失败模式),为指定路线写出一段不超过三句话的路线画像;
- 解释 scan-to-BIM 为什么不是“扫描完自动出模型”,指出自动化算法能完成哪些步骤、哪些判断仍必须由人承担;
- 读图 2,说出横轴、纵轴与气泡大小分别代表什么,并把 A、B、C、D 四个气泡与 4.1—4.4 节的四条路线逐一对应(图注字母的顺序与“路线一至四”的编号顺序并不一致);
- 用图 3 的场景 × 路线适配度矩阵,为“标准化住宅 / 厂房”与“古建与历史建筑”两类场景各选一条主路线,并说明依据;
- 用 4.6 的五个问题与 4.7 的四套工序,为一个具体项目写出主路线选择与人力配置的两段结论。
路线之争大多是伪命题:真实项目里,四条路线往往同时出现在同一栋楼的不同部位;关键是知道每条路的能力边界与代价。
这一章把翻模的技术路线拆成四类,分别讨论其原理、适用条件、精度上限、人力结构与失败模式,最后给出场景适配矩阵与混合路线建议。
4.1 路线一:图纸规则化半自动
原理是“把识图规则写成程序”:解析 DWG/DXF 的图层、块、线型、文字与标注,按预设映射规则识别墙、柱、门窗等构件,批量生成参数化构件,再由人工修正异常。常见实现方式包括 CAD 二次开发(AutoLISP/.NET/ObjectARX)、BIM 平台插件(Revit API/Dynamo)、独立解析库(如 ezdxf 这类开源 DXF 库)以及商业翻模软件。
表 14 图纸规则化半自动路线画像
| 维度 | 说明 |
|---|---|
| 适用条件 | 图纸规范度高(图层清晰、块化程度好)、构件类型标准化、批量化需求明显 |
| 精度上限 | 可达到构件级;几何精度取决于图纸标注质量与人工修正 |
| 人力结构 | 少量标准工程师 + 脚本开发 + 多数建模人员(做修正) |
| 典型周期 | 首个项目较长(搭工具),后续项目显著缩短 |
| 失败模式 | 图纸不规范导致规则失效;脚本维护成本高;过度依赖图层导致漏构件 |
资料来源:本报告归纳。
这条路线的价值在于把一次性劳动转化为可复用资产:一套图层映射表与脚本,可以在几十个项目上反复使用。它的隐性成本是“工具债”——图纸规范一变,脚本就要改,因此需要专人维护,而不是做完就扔。
4.2 路线二:参数化 BIM 重建(正向重建)
原理是“按工程逻辑重新建模”:以轴网、标高为骨架,用参数化族与类型系统逐层搭建构件,构件之间保持正确的连接与约束关系。它不是“照着图纸画”,而是“按建造逻辑重建”,因此模型的可编辑性与信息完整性最好。
这条路线的成本最高,但产出质量也最高,适合复杂公建、异形结构、需要后续深化或运维的项目。关键能力不在软件操作,而在建模策略:先定轴网与标高,再定构件拆分粒度,最后定属性体系。策略错了,后期改一处会牵动全身。
4.3 路线三:点云 / 实景逆向(scan-to-BIM)
原理是“用实测数据约束几何”:通过激光扫描或倾斜摄影获取现状点云/影像,提取墙面、楼板、梁柱、洞口等几何特征,再拟合成构件。它解决的是“图纸不可信”的问题,适用于既有建筑改造、古建保护、竣工核实。
需要澄清一个常见误解:scan-to-BIM 不是“扫描完自动出模型”。自动化算法可以完成点云配准、切片、平面/圆柱拟合、洞口检测等步骤,但构件语义(这是承重墙还是隔墙、这处改动是否合规)仍需人工判断。实际项目中,自动处理通常承担 40%—70% 的初稿工作量,剩余部分依赖人工。
4.4 路线四:AI 端到端
原理是“用模型直接学习图纸到三维的映射”:以大量图纸—模型配对数据训练神经网络,输入图纸图像或矢量,直接输出构件或参数化模型。2024—2026 年这一方向进展明显,学术界的代表性工作包括 AAAI 2025 的《From 2D CAD Drawings to 3D Parametric Models: A Vision-Language Approach》(arXiv:2412.11892),以及 2025 年发表于 Computer-Aided Design 等期刊的强化学习参数化重建研究。
产业侧,2026 年的主流 BIM 软件已把 AI 助手嵌入建模环境:Autodesk Revit 2027(2026 年 4 月发布)引入 Autodesk Assistant(技术预览),可查询与分析模型数据、创建视图与明细表、在上下文中编辑参数,厂商同时明确技术预览阶段“不提供承诺与担保”;AutoCAD 2027(2026 年 3 月发布)的 Assistant 开始借助 Model Context Protocol(MCP)理解用户正在做的工作;Autodesk 于 2026 年 6 月发布 Revit Public MCP Server(技术预览),以 stdio 方式提供只读访问。
截至发布时的公开信息,Revit Public MCP Server 提供 7 个只读工具:获取运行中的 Revit 实例、查询模型、读取构件数据、选择构件、缩放定位、打开视图、导出视图。这组能力的边界很清楚——能查、能看、能导,不能改图。把它放进翻模流程,最有价值的用法是“问模型”(比如这批门是否缺防火分区属性)、“定位问题构件”、“批量导出视图用于核对”,而不是“让 AI 替你把这一层建出来”。
这些能力的共同点是增强而非替代:它们提高检索、批量修改与问题定位的效率,但不承担“图纸是否正确”的判断责任。招标或报价时按“AI 自动翻模”计价,是当前最典型的能力错配。
对 AI 的合理预期:现阶段 AI 在翻模中最可靠的价值是“减少重复动作”与“快速给出初稿”,而不是“无人值守产出可交付模型”。把 AI 当成一个不知疲倦但需要复核的实习生,比把它当成替代方案更接近现实。
4.5 四条路线的对比与选型
把四条路线放在同一张图上(图 2),可以看到它们各自的定位:点云逆向的精度最高但属性最弱;参数化重建的可用性最高但成本最高;规则化半自动的性价比最好;AI 端到端速度最快但语义受限。
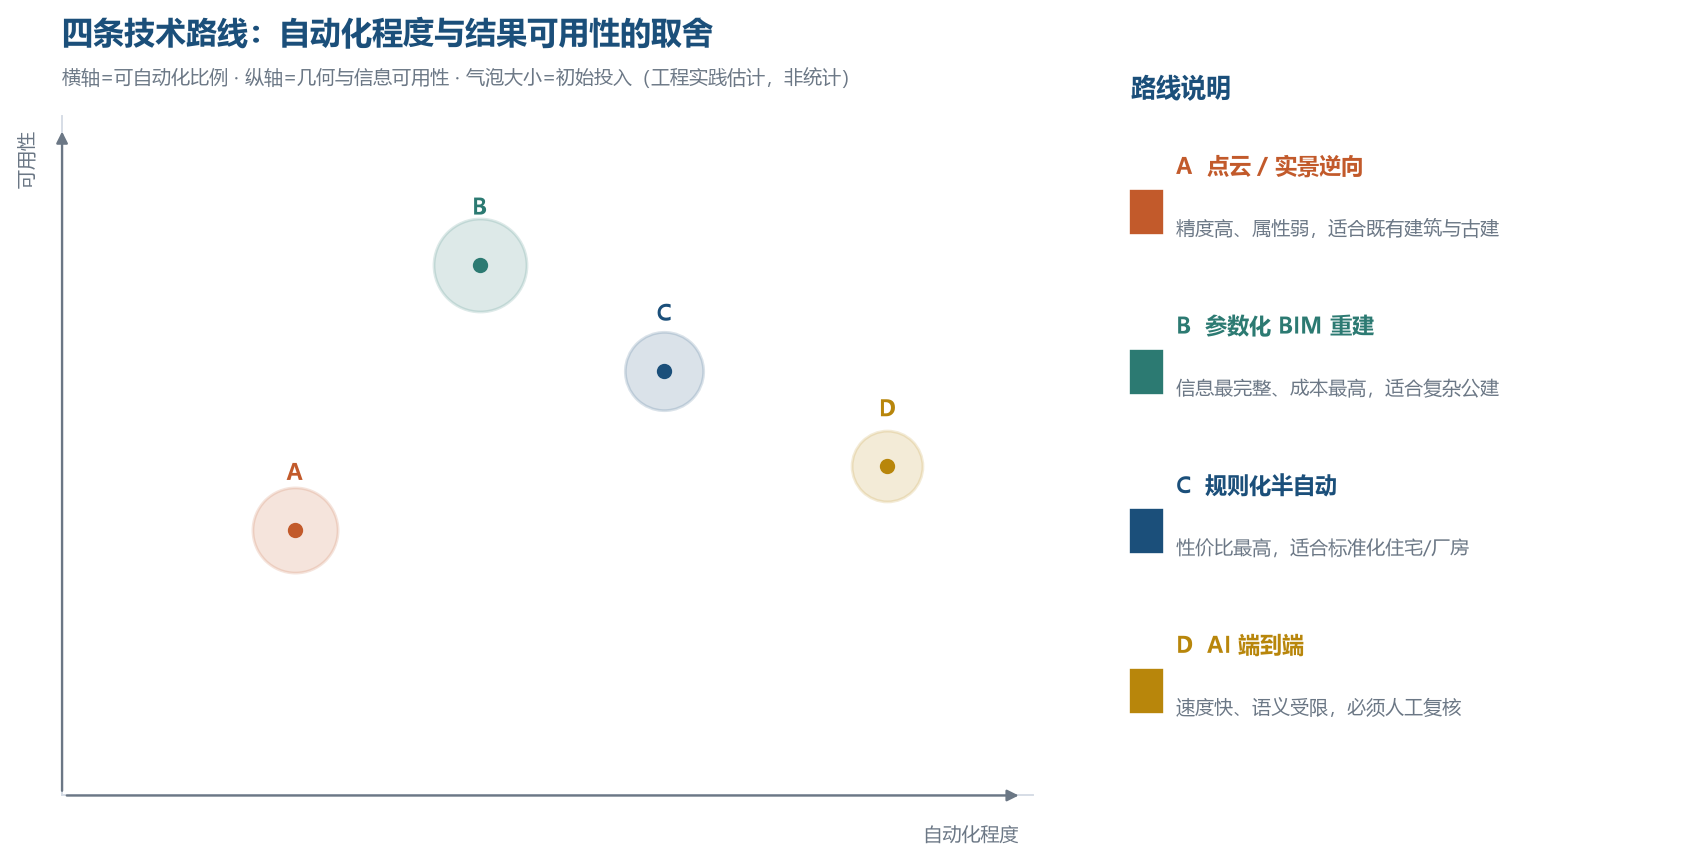
图 2 四条技术路线的定位(气泡大小表示初始投入)
资料来源:本报告归纳,为工程实践估计,非统计结果。
场景适配矩阵(图 3)进一步说明了“什么场景选什么路线”:
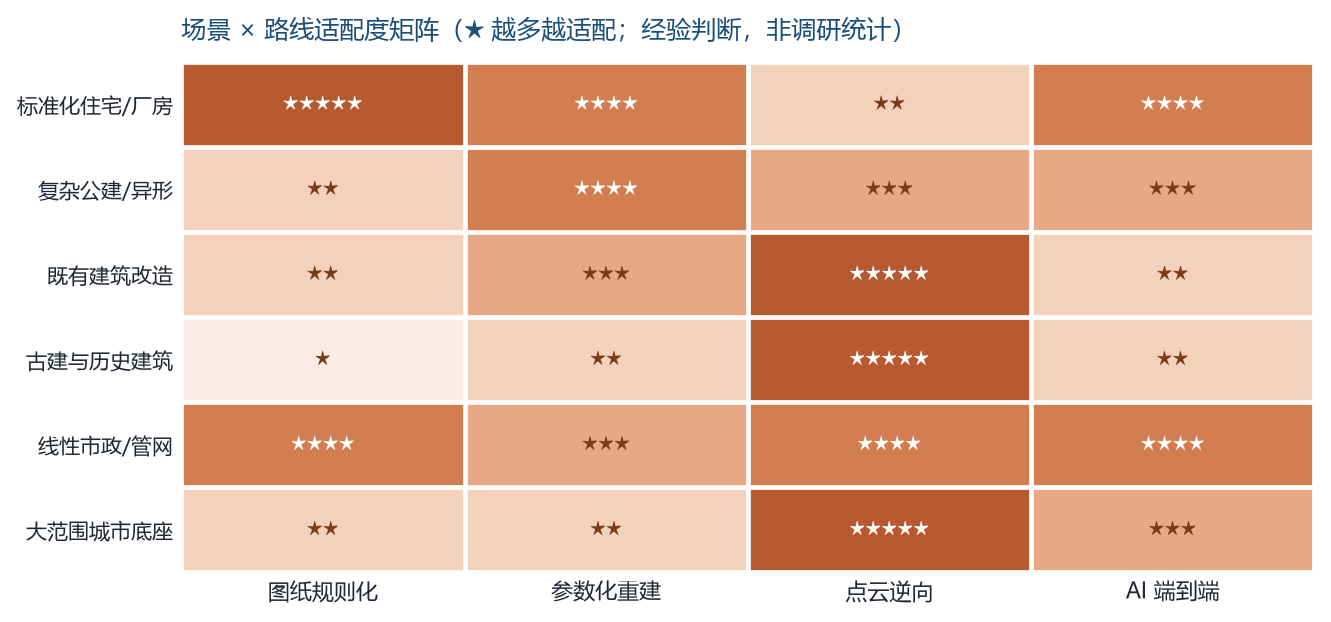
图 3 场景 × 路线适配度矩阵
资料来源:本报告评估。
实际项目几乎不会只用一个路线。一个典型的混合方案是:主体结构用规则化脚本批量生成,复杂节点用参数化手工重建,改造部位用点云校核,AI 用于批量属性填充与图纸文字提取。混合的关键是统一坐标、统一命名、统一属性字典——否则四条路线产出的模型拼不到一起。
4.6 选型决策清单
- 图纸可用吗?图层规范、版本一致、标注完整 → 优先规则化;图纸不可信 → 点云或实测。
- 用途是什么?算量与审查要求构件语义完整 → 参数化或规则化;只要空间关系 → 实景或轻量化。
- 有多少重复量?同类构件成百上千 → 脚本化收益最高;一次性的异形构件 → 手工重建更划算。
- 有时间压力吗?AI 端到端适合“先出初稿再迭代”;点云适合“精度优先、工期可让”。
- 团队会写脚本吗?没有工具能力,规则化路线会退化为“更贵的手工”。
4.7 四条路线的典型工序与人力配置
选型之后真正的难题是“怎么排产”。四条路线的工序差异很大,人力结构也不同,下面给出可直接对照的工序表。
4.7.1 图纸规则化:先做工具,再做产量
1.图纸归一:统一图层、单位、图框,把不同版本图纸转到同一基准。 2.规则提炼:抽取 1—2 张典型平面,人工识别构件与图层的对应关系,形成映射表。 3.脚本开发:实现图层识别、构件批量生成、属性批量写入、异常清单输出。 4.样板验证:在典型层上跑通,与人手建模结果对比,修正规则。 5.批量生产:按分区跑脚本,人工处理异常清单,逐层提交。 6.持续维护:图纸规范变化时同步更新规则与脚本。
人力上,这条路线的关键岗位是“标准工程师 + 脚本工程师”,建模人员的角色从“画”转为“修”。一个常见误区是让脚本工程师独立于建模团队工作,结果脚本无法覆盖真实异常;正确做法是两者同组、同项目、同评审。
4.7.2 参数化重建:策略先于操作
参数化重建的工序核心是“先定骨架、再定构件、后定属性”:轴网与标高先行,其次是结构构件(柱、梁、板、墙),再是建筑构造(门窗、楼梯、幕墙),最后是机电与设备。每一步都要做一次“模型健康检查”,避免错误累积。
这条路线的效率瓶颈通常不在建模速度,而在判断速度:一个节点该用什么构造、一处洞口该归哪个专业,需要专业负责人快速决策。经验上,专业负责人的响应速度直接决定整条产线的节拍,因此要为其预留固定的“答疑窗口”,而不是随叫随到。
4.7.3 点云逆向:把“扫描”当成一项工程
scan-to-BIM 的完整工序包括:现场踏勘与布站/航线设计 → 控制点布设与测量 → 数据采集 → 点云配准与精度检查 → 去噪与切片 → 构件拟合 → 人工补建与语义赋值 → 与图纸或实测复核。其中“控制点”与“精度检查”最容易被省略,也最容易在交付时暴露。
需要提醒的是,点云建模的工期与“需要扫描的面积”不是线性关系:复杂的室内环境(吊顶、管井、设备间)单位面积耗时可能是开敞空间的数倍。报价时应按“空间复杂度”分档,而不是只按面积。
4.7.4 AI 端到端:把它放在流程的正确位置
AI 生成的结果适合放在流程的前端(快速出初稿、辅助识图)与后端(批量检查、属性补全),而不适合放在中段替代人工判断。一个可行的分工是:AI 生成初稿 → 人工筛选与修正 → 规则脚本批量校验 → 人工终检。这样既利用了速度,又保留了责任边界。
本章小结
- 四条路线分别是图纸规则化半自动、参数化 BIM 重建、点云 / 实景逆向与 AI 端到端;它们是同一栋楼不同部位的可选工具,不是互斥的立场之争。
- 规则化半自动把一次性劳动转化为可复用资产:一套图层映射表与脚本可以在几十个项目上反复使用;代价是“工具债”——图纸规范一变,脚本就要改,必须专人维护,而不是做完就扔。
- 参数化重建成本最高、产出质量也最高,关键能力在建模策略(先轴网与标高、再构件拆分粒度、最后属性体系)而非软件操作;策略错了,后期改一处会牵动全身。
- scan-to-BIM 不是“扫描完自动出模型”:自动算法可完成配准、切片、平面 / 圆柱拟合与洞口检测,但构件语义与合规判断仍靠人;工程中自动处理通常承担 40%—70% 的初稿工作量。
- AI 端到端目前是“增强而非替代”:Revit Public MCP Server 的 7 个只读工具做到能查、能看、能导而“不能改图”,按“AI 自动翻模”计价是当前最典型的能力错配。
- 图 2 以可自动化比例为横轴、几何与信息可用性为纵轴、气泡大小表示初始投入,把四条路线的定位摊开;图 3 的适配度矩阵进一步回答“什么场景选什么路线”。
- 混合路线是常态:主体结构用脚本批量生成、复杂节点手工重建、改造部位用点云校核、AI 做批量属性填充与文字提取;前提是统一坐标、统一命名、统一属性字典,否则四路产出拼不到一起。
- 选型看 4.6 的五问(图纸是否可用、用途、重复量、工期、团队会不会写脚本)与 4.7 的四套工序;参数化路线的节拍瓶颈往往是专业负责人的判断速度,而不是建模速度。
思考与练习
- 取一套你手上(或公开渠道)的住宅标准层施工图,按表 14 的五个维度写一段“规则化半自动”的路线画像;再列出三条最可能让脚本失效的图纸特征,并为每条配一个可执行的校验动作。
- 图 2 中 A、B、C、D 四个气泡与 4.1—4.4 节的“路线一至四”并非同序。请先完成对应关系,再在不改动图的前提下写一段 150 字以内的读图说明,把横轴、纵轴、气泡大小三件事讲清,并提醒读者不要按字母顺序对号入座。
- 一个既有建筑改造项目:图纸版本混乱、缺立面与剖面,甲方要求三个月内交出可进审查流程的模型。请用图 3 与 4.6 的清单,写出主路线加辅助路线的组合,说明哪一部分必须外业实测,以及背后缺的是哪一类依据。
- 团队 6 人,其中 1 人会写脚本、1 人有族库经验。请按 4.7.1 与 4.7.2 的工序表排一个 8 周的主体结构建模计划:标出脚本开发与样板验证各占几周,异常清单由谁处理,专业负责人的答疑窗口每周定在什么时候。
- 乙方提出“用 AI 端到端把整层建出来,只留一人复核”。请据 4.4 的 7 个只读工具边界,写一段不超过 200 字的书面回应:能接受哪部分、不接受哪部分、验收时抽查什么、价格按什么口径折算。
- 把 4.6 的五个问题改写成一张 5 行的“选型记录单”(问题、答案、结论路线、待确认事项),并说明为什么“团队会不会写脚本”这一问必须落成书面结论——如果只在口头上过了,规则化路线会在哪个环节退化成“更贵的手工”。
| 上一章:第03章 政策、标准与合规:翻模的外部约束 | 返回目录:CAD 图纸翻模三维模型全景教程 | 下一章:第05章 工具链与数据格式:别让格式成为交付瓶颈 |